
AI日程調整、AIスカウト、AI求人票、AIエージェントコミュニケーション…etc。採用業務の一つひとつをAIエージェントに任せられるようになってきました。
ただ、AIが採用実務を担うほど、別の問題が出てきます。「そのAIは、何を基準に候補者を見て、求人を書き、スカウトし、人材紹介会社へフィードバックするのか?」AIエージェントごとに異なる基準で動いてしまえば、採用業務を自律実行できても、採用全体を一貫して改善していくことは難しくなります。
そこでフェアパスでは、求人ごとの選考結果から更新され続ける共通の判断基盤として「採用モデル」を実装しました。
こんにちは! bgrass事業責任者のゆあさです。
今回は、フェアパスが複数の採用AIエージェントをどう束ねているか、その中心にある「採用モデル」について書きます。
採用AIエージェントOSとは
採用AIエージェントOSとは、日程調整、候補者対応、スカウト、選考支援など、これまで採用担当者が行っていた実務をAIが自律的に進める仕組みです。
フェアパスでは、それらをバラバラのAI機能としてではなく、「AI採用チーム」として設計しています。日程調整や候補者対応などのオペレーションをAIが実行し、そこで蓄積された選考データから採用モデルを更新する。そのモデルを、求人票改善や人材紹介エージェントとのコミュニケーション、スカウトなど次の採用アクションへつなげていきます。
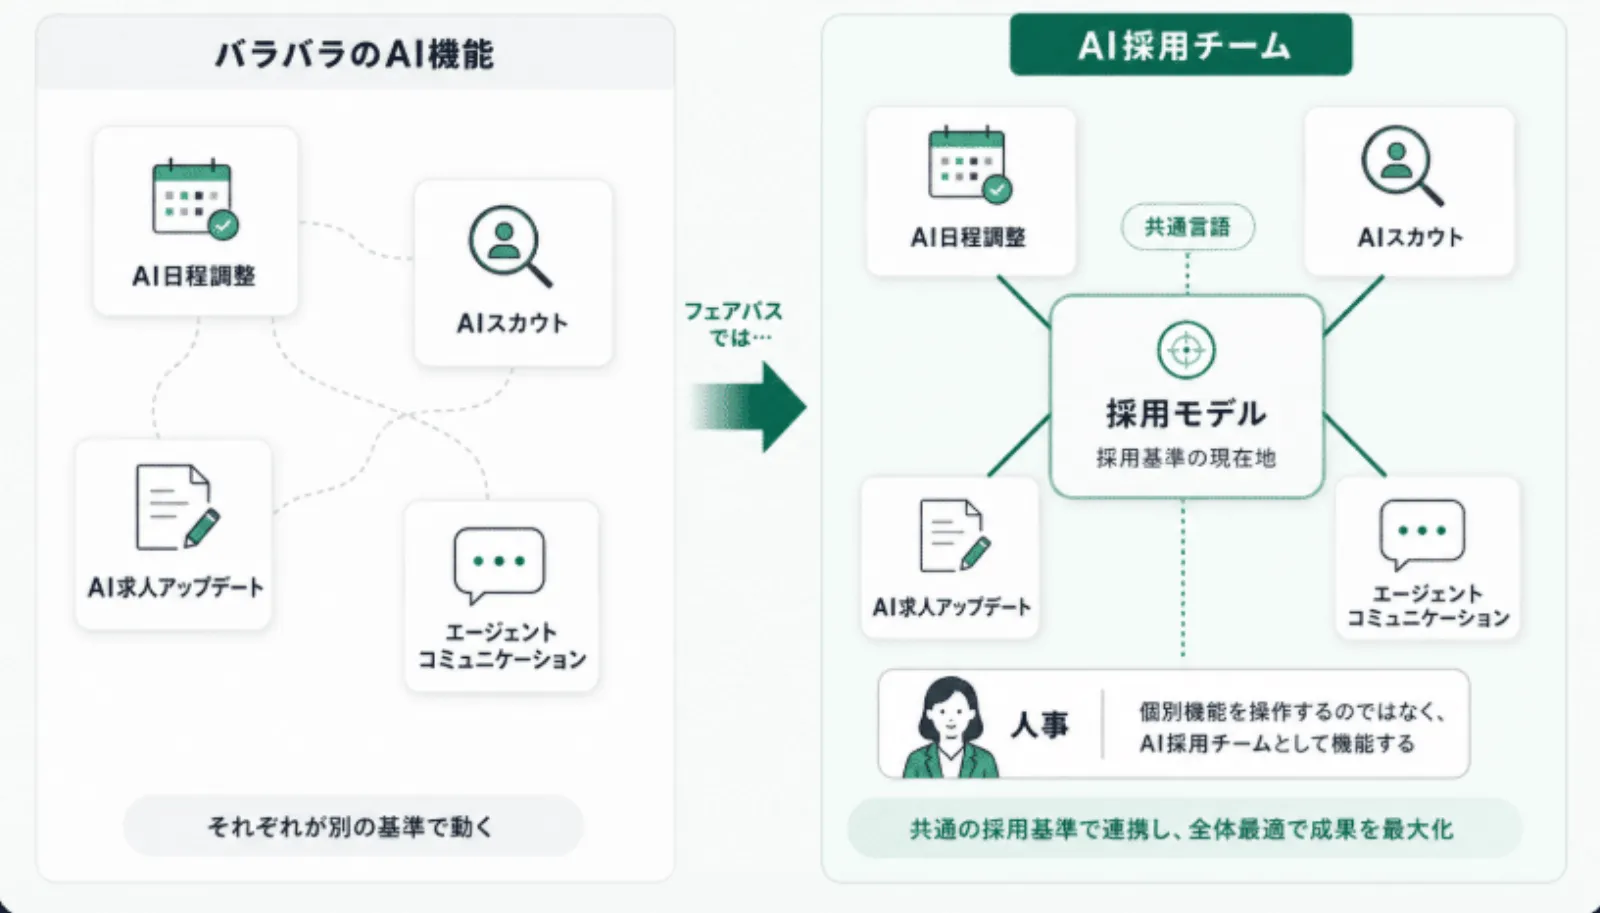
バラバラなAI機能ではなく、『AI採用チーム』として設計
採用モデルとは何か
採用モデルとは、求人ごとに蓄積された選考データから「自社では実際にどんな人が通過してるのか見送られてるのか」を構造化した、採用AIエージェントの判断基盤です。
分かりやすく言えば、**求人ごとの「採用基準の現在地」**です。担当者が要件を書き直したり、暗黙知を頑張って言語しなくても、採用選考を進めている限り更新され続けます。
どうやって採用モデルを作っているのか
採用モデルは、3つのステップで作られます。
- 選考データを読む:応募・職務経歴の要約・面接の評価コメント・見送り理由を、求人ごとにまとめて読みます
- 特徴を洗い出して、該当する人を判定する:必須スキル「SaaSの開発経験」、ソフトスキル:「設計判断の背景を論理的に説明できる」のような項目を洗い出し、候補者ごとに該当するかを判定します。ここまでがAIの担当です
- 通過結果との関連を計算する:通過した方と見送りになった方で、その項目の該当率にどの程度差があるかを計算します。この計算はAIではなくプログラムが行うため、同じデータなら必ず同じ結果になります AIに全部を任せるのではなく、特徴の抽出・判定はAIが担い、通過結果との差の計算は再現性のあるプログラムに任せる。この役割分担によって、AIの柔軟性と計算結果の再現性を両立させています。
採用モデルに載る2種類の項目
採用モデルに載る項目には、2種類あります。
1つは、経歴の特徴(ハードスキル)です。職務経歴の要約から判定され、「Node.js/TypeScriptの実務経験3年以上」や「RDB設計の実務経験1年以上」のような項目が該当します。書類選考の結果と結びつけやすい項目です。
もう1つは、仕事の進め方の特徴(ソフトスキル)です。面接官の評価コメントから判定され、設計判断の背景を論理的に説明できる、「他部署を巻き込んだ業務調整の経験」、等といった経歴書だけでは判断できない項目が該当します。「経歴は合っているのに、面接で見送りになる」という現象の理由は、こちらに現れます。
後者は面接に進んだ方にしか評価コメントがないため、書類通過との関連としては確定しにくく、「データ不足」のまま残ることがあります。これは判定を省いているのではなく、比較できる母数がまだない、という意味です。
「確定」と「傾向」を分ける
実装してみて特に難しかったのは、「傾向が見えている」と「採用基準として使ってよい」を分けることでした。
項目には、「確定」「検証中」「データ不足」といった状態があります。通過した方と見送りになった方の差が、一定の件数から確認できているものを「確定」、傾向は見えているもののまだ件数が十分でないものを「検証中」、判断できるだけのデータが集まっていないものを「データ不足」として扱います。
確定した項目は、人材紹介エージェントへのフィードバックだけでなく、求人票の見直しやスカウト条件、今後の採用アクションなど、複数のAIエージェントが活用する判断材料になります。
ただし、少ない選考結果だけで採用基準を断定しないため、一定のデータが蓄積されるまでは項目を確定させません。これは、少数の結果から採用基準を過度に狭めたり、誤った傾向を実行に使わないために、フェアパス側で設けている最低限の安全基準です。
「消さない・上書きしない・載せない」という3つの設計思想
採用モデルには、3つの設計思想があります。
1つ目は、「無関係」も消さないことです。調べた結果、通過とは関係がないと分かった項目も残します。消してしまうと、同じ項目を何度も検証し直すことになるためです。
2つ目は、上書きせず版を積むことです。モデルは更新のたびに新しい版を作ります。送ったフィードバックが、どの版のモデルに基づいていたかを後から辿れるようにするためです。
3つ目は、採用モデルに載せない項目をあらかじめ決めていることです。年齢・性別・国籍・出身校・学歴・家族構成・健康状態は、フェアパスでは採用モデルの判断材料として扱わないと定めています。
採用モデルは、求人票の改善、人材紹介エージェントへのフィードバック、スカウト条件など、複数の採用アクションに活用される判断基盤です。だからこそ、特定の属性が一度モデルに入ると、その後の複数のAIエージェントの判断や実行に影響する可能性があります。**何をモデルに入れ、何を入れないかは、個別機能ではなく採用全体に関わる設計です。 ** また、人材紹介エージェントへ送る推薦精度レポートについても、候補者の氏名・連絡先・在籍企業名は載せません。候補者は推薦順の連番で表記し、推薦日や経歴情報をもとに確認できる形にしています。
もちろん、年齢や性別などの属性をモデルから除けば、それだけで公平な採用になるわけではありません。そもそも過去の選考結果や評価コメント自体に、人の判断による偏りが含まれている可能性もあります。だからフェアパスでは、「過去に通過した人に似ているから採用する」という使い方ではなく、どの特徴と選考結果に関連が見られたのかを可視化し、判断根拠を追える状態にすることを重視しています。
『AIだから公平なのではなく、何を判断材料にし、何を判断材料にしないのかを設計し続けること』が、公平な採用につながると考えています。
採用モデルは、AIエージェントの「共通言語」になる
採用モデルは、単体の分析レポートではありません。現在は、人材紹介エージェントへの推薦精度レポートや求人票の改善に活用し、今後はスカウトなどより母集団形成にも活用範囲を広げていきます。
フェアパスでは、こうした複数の採用AIエージェントが、同じ採用モデルを「共通言語」として動く状態を目指しています。
AI求人アップデート:求人票に書かれた要件と、実際の通過者・見送り者の傾向を照らし合わせ、選考結果をもとに求人票を見直します。 エージェントコミュニケーション:採用モデルと人材紹介エージェントごとの推薦結果を照合し、「次にどんな人を推薦してほしいか」を推薦精度レポートとしてAIが作成します。現在は人事が内容を確認・承認してから送付する設計です。 AIスカウト:通過者に多い特徴を、スカウトの検索条件や文面へ反映する設計を進めています。
求人票、スカウト、人材紹介会社へのフィードバックが、それぞれ別の採用基準で動くのではなく、同じ採用モデルを「共通言語」として動く。これが今回お伝えしたかったことです。
人事からは、「スカウトを送っている」感覚すらなくなる
フェアパスが目指しているのは、人事が「今日はスカウトを送ろう」「次はエージェントコミュニケーションと取るために直近の内定者傾向を分析してコアになりとりしている10社に送ろう」と、AIエージェントを一つひとつ操作する世界ではありません。
採用モデルをもとに必要なAIエージェントが裏側で動き、人事が個々の処理を意識しなくても、自社の選考データをもとに、自社にマッチする候補者との接点をAIが継続的に増やしていく状態を目指しています。
現在は推薦精度レポートや求人アップデートから実装を進めており、その先にスカウトを含む母集団形成までつなげていきます。
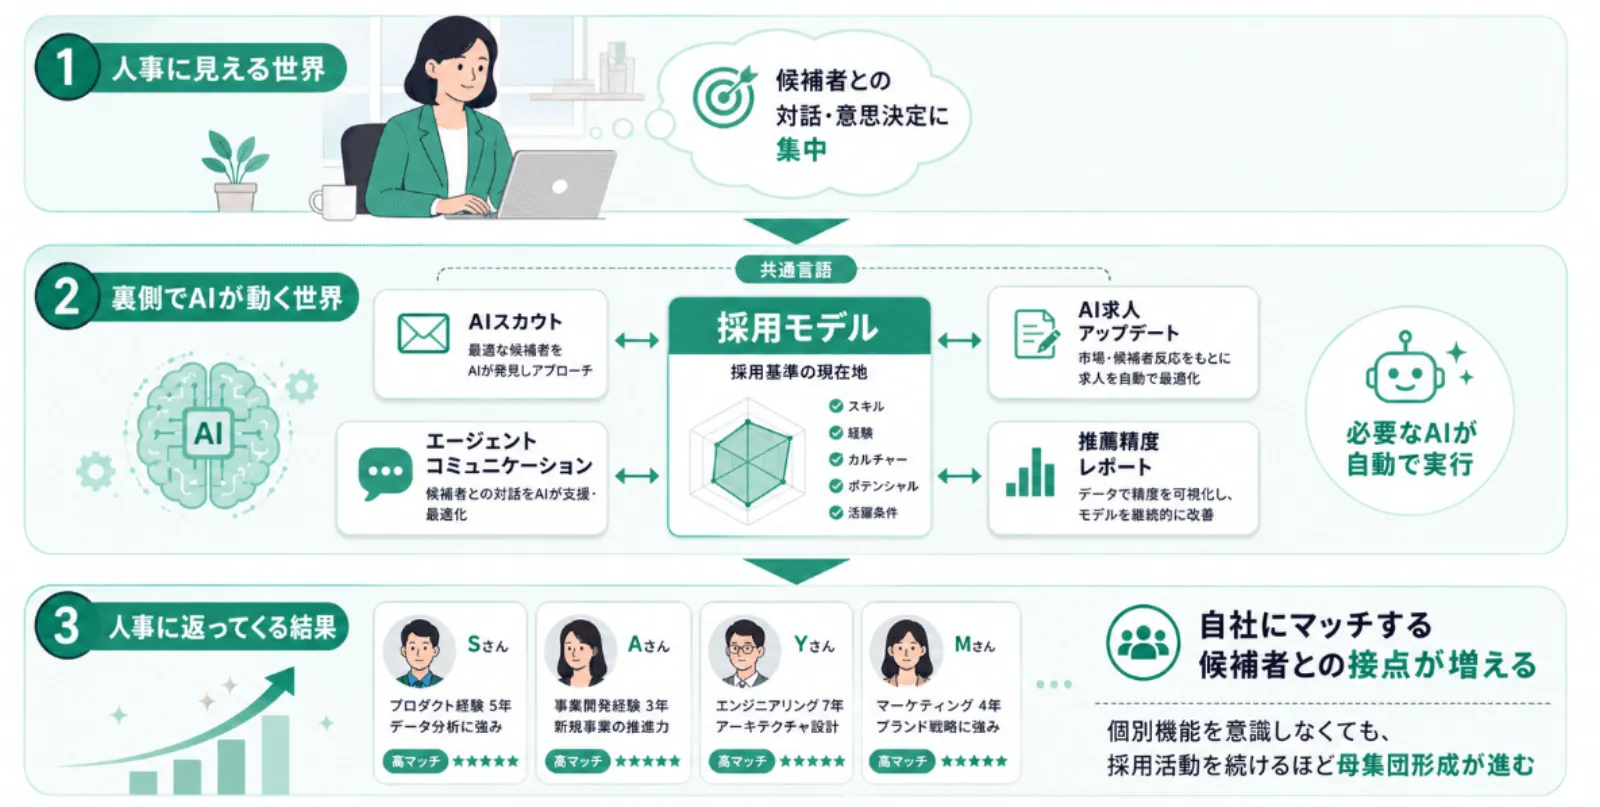
採用モデルは、HRの実務知とAI・データ設計の両方がないと作れない
採用モデルを作るうえで難しいのは、AIに選考データを読ませること自体ではありません。難しいのは、AIに何を判断させ、何を判断させないのかを設計することです。
例えば、一定の選考データが蓄積されるまでは項目を確定しないこと。年齢・性別・出身校などを判断材料にしないこと。こうした設計は、統計的に処理できるかどうかだけでなく、その情報が実際の採用現場でどう使われ、どんなリスクを生むかまで理解していないと決められません。ここには、海外市場におけるAI規制なども含めた深い知見が必要不可欠です。
一方で、「確定」「検証中」「データ不足」を分けて扱うことや、通過結果との関連を同じデータなら必ず同じ結果になる形で計算することには、AI・データ設計の知識と経験が必要です。
つまり、採用モデルはHRだけでも、AIだけでも作れません。フェアパスでは、幸いにもこの両方に強みをもったコアメンバーが中心となり設計しています。
**採用の現場で何を判断材料にすべきかを知るHRの実務知、AI時代の採用組織をどう設計するかという経営視点、そしてそれを再現可能な仕組みに落とし込むテックのAI実装力。 ** この3つを行き来しながら設計しているのが、フェアパスの採用モデルです。
今回の採用モデルも、HR側が要件を出してテック側が作ったものではありません。実際の選考現場で起きていることをもとに、「この情報は使ってよいのか」「この件数で確定してよいのか」「AIに判断させるのか、プログラムで固定するのか」といった一つひとつの判断を、HRとテックが一緒に議論しながら実装しています。
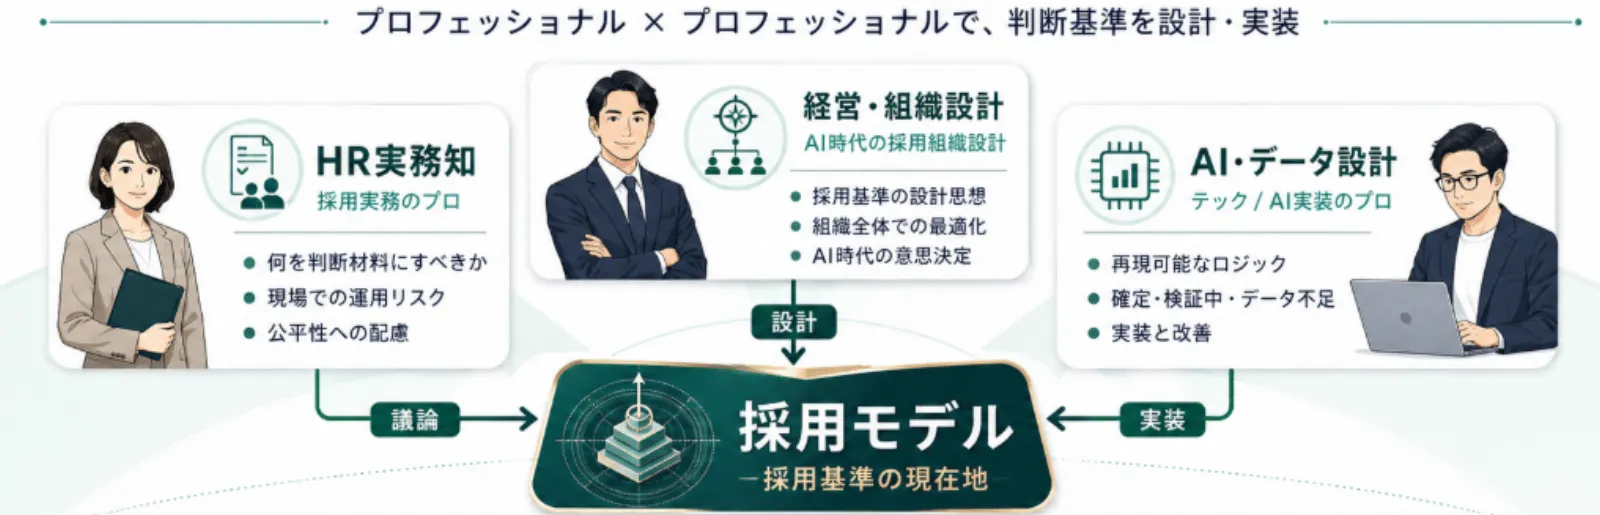
実務知 × 経営視点 × AI実装力 = 採用モデルが初めてワークする
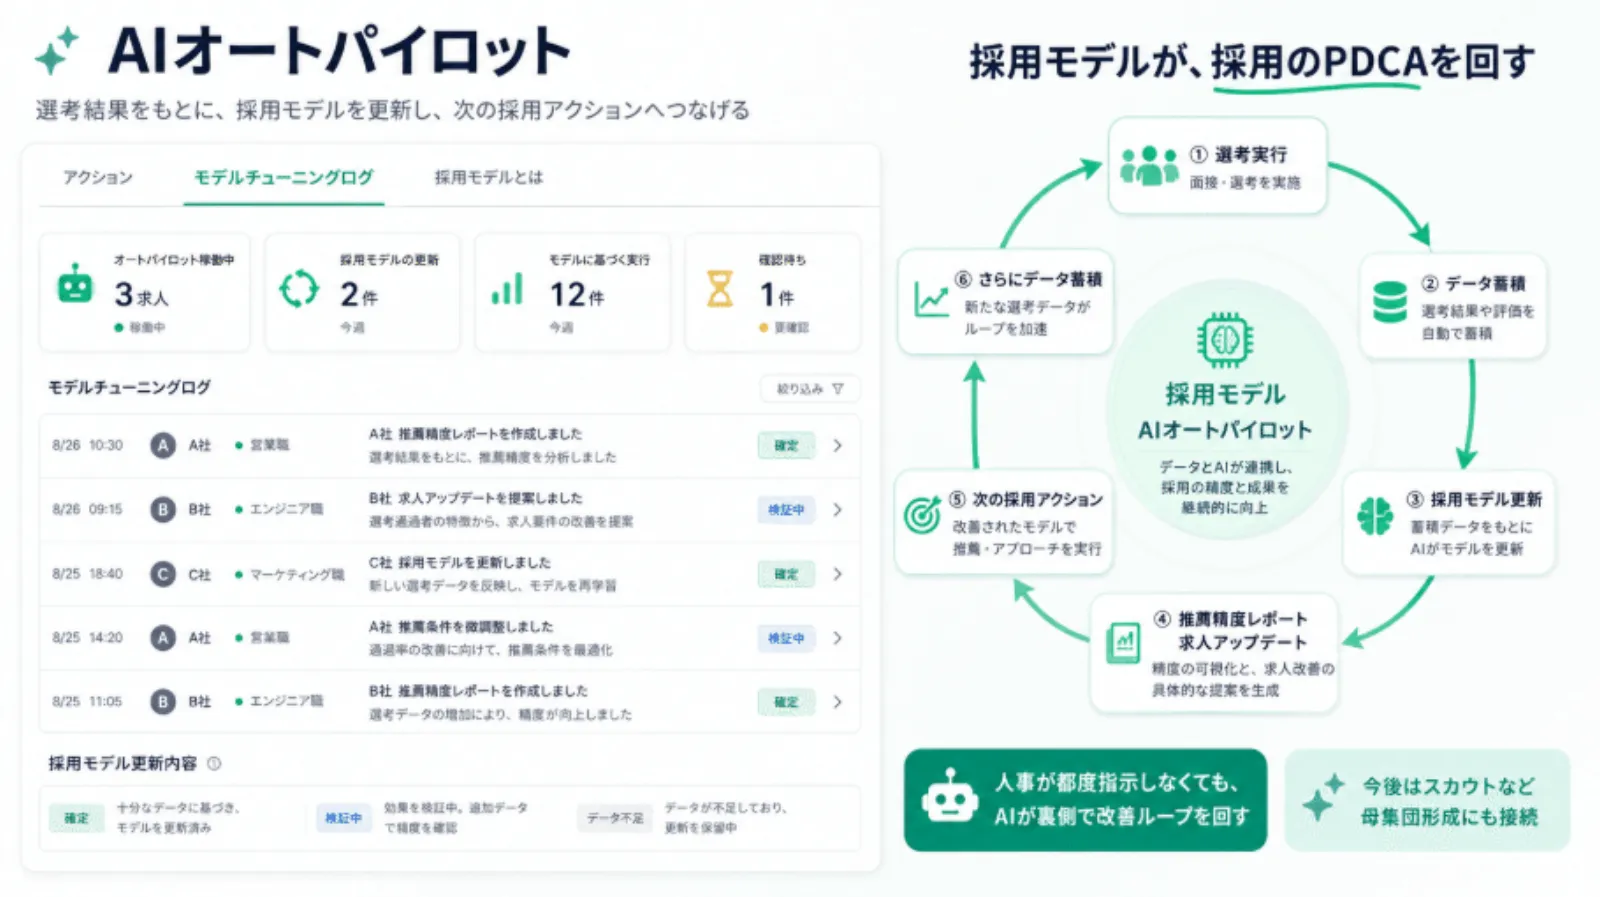
採用モデルが、採用のPDCAを回す
フェアパスでは、この一連の循環を「AIオートパイロット」として実装しています。人事が毎回「採用モデルを更新してください」と指示するのではなく、選考結果が蓄積されるとAIがデータを読み、求人ごとの採用モデルを更新します。現在は、その結果を人材紹介エージェントへの推薦精度レポートや求人票の改善へつなげています。
採用モデルの役割を1つの流れにすると、次のようになります。
選考を実行する → 応募・評価・見送り理由が蓄積される → AIオートパイロットが採用モデルを更新する → 推薦精度レポート・求人アップデートに反映される → その結果を次の採用アクションへつなげる → さらに選考データが蓄積される。
今後はここにスカウトなどの母集団形成も加わり、採用モデルの更新がそのまま「自社に合う候補者との接点を増やすアクション」までつながっていく設計です。
この循環が、フェアパスが目指している「採用のPDCAをAIが回す」という状態の中身です。
人が要件を更新する採用から、「採用そのものが学習する」世界へ
これまでの採用システムは、人が設定した採用要件に従って動くものでした。
これからの採用AIエージェントは、実際の選考結果から蓄積されたデータをもとに、AIオートパイロットが採用モデルを更新し、その結果を求人票、スカウト、人材紹介エージェントへのフィードバックなど、次の採用アクションへ戻していきます。つまり、AIが業務を自律実行するだけでなく、採用活動そのものが学習し続ける状態を作れるようになります。
フェアパスが作ろうとしているのは、AI日程調整やAIスカウトといった機能の集合体ではありません。選考データを起点に、複数のAIエージェントが連携しながら採用全体を継続的に改善していく採用AIエージェントOSです。
将来的には、人事が「スカウト媒体を運用する」「人材紹介エージェントへ推薦条件を伝える」といった個別業務を意識すること自体が減っていくと考えています。人事が候補者との対話や意思決定に集中している間にも、裏側では採用モデルをもとに必要なAIエージェントが動き、次の採用アクションを実行していく。人事から見れば、自社の選考データを起点に、自社に合う候補者との接点が継続的に増えていく状態です。
選考するほど採用モデルが育ち、採用モデルが育つほど次の採用アクションが変わっていく。この循環まで含めて、私たちは採用AIエージェントOS「フェアパス」を作っています。
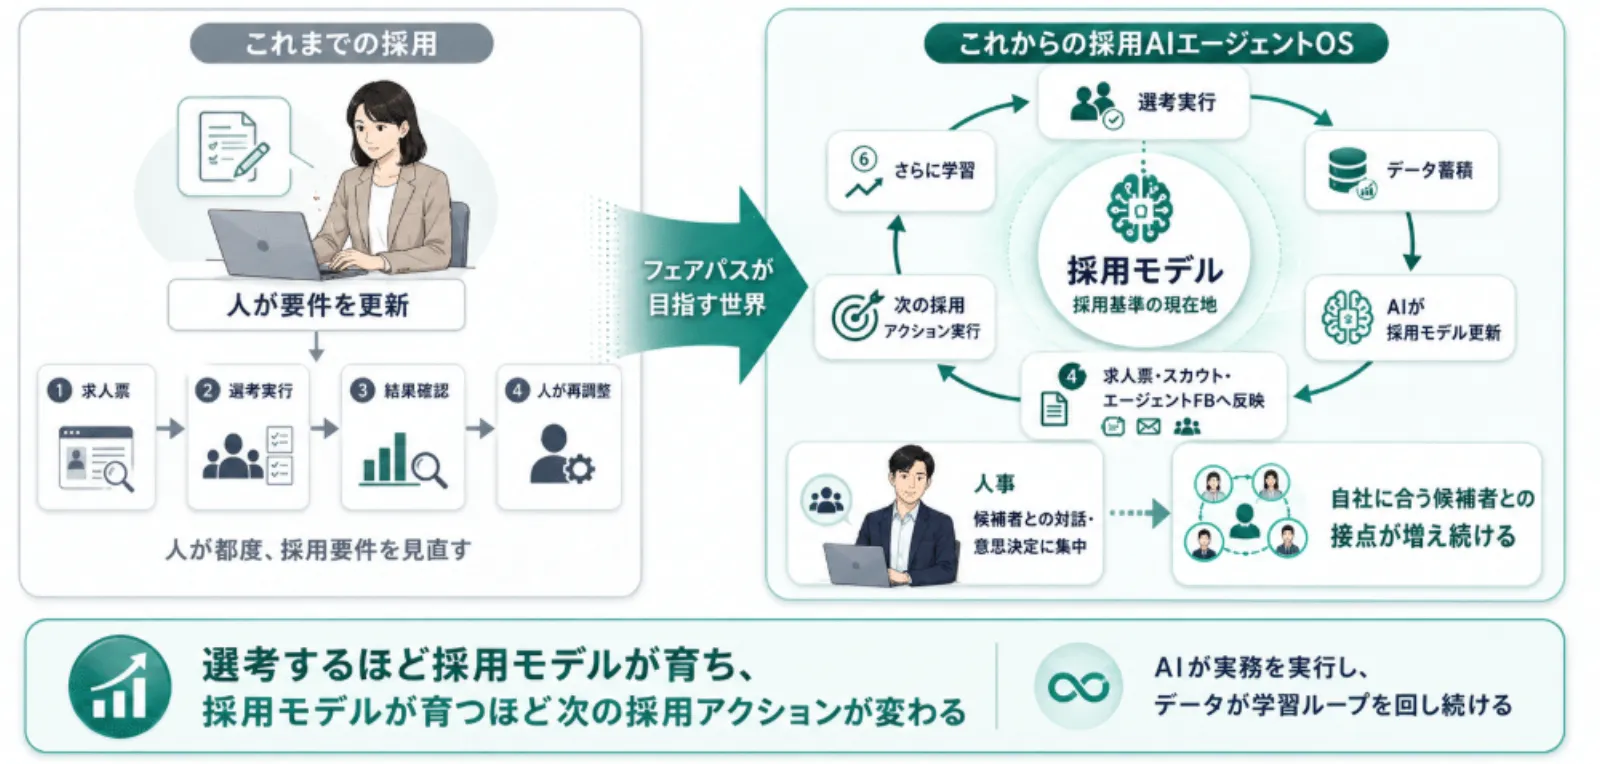
「採用そのものが学習する」世界へ
「採用モデル」が、求人改善・エージェントコミュニケーション・AIオートパイロットにどう繋がっているのか、フェアパスの現在の仕組みをご覧ください。
採用モデルが実際にどう動くかを見る👇
執筆者|ゆあさ bgrass株式会社|事業責任者 HR領域を中心に採用責任者、RPO、新規事業責任者、BizDev、COO等を経験。複数企業の採用現場で採用戦略・採用オペレーション・AI導入支援に従事。現在はRecruiting Agent OS「フェアパス」の事業責任者を担当