
【エグゼクティブリード】 人材紹介会社に必要なのは、静的なペルソナではなく「実際の選考結果から分かる、いまの採用基準」です。エージェントコミュニケーションと呼ばれる手法の多くは管理・統制を前提にしていますが、推薦のズレを縮めるのは管理ではなくデータの共有でした。実際に生成している推薦精度レポートの構成をもとに、AIが担うエージェントコミュニケーションの形を書きます。
こんにちは。bgrassでBizDevを担当しているまいかです。
これまで4回にわたり、選考データや面接の一次データを実務と繋ぐことで、採用がどうオートパイロットで回り始めるのかを書いてきました。前回まではどちらかというと全体像や考え方の話が中心でしたが、今回はより現場寄りの、実際の運用の話をします。
テーマは、多くの採用担当者が頭を悩ませている人材紹介・エージェントコミュニケーションです。
世の中にはエージェントコミュニケーションのためのノウハウがあふれています。各社と定期的に面談をしよう、推薦目標を握ろう、進捗をこまめに確認しよう。どれも実際に効果のある方法ですし、私たちも支援先で同じことをやってきました。
ただ、これらはすべて人が時間をかけて属人的に担ってきた領域でもあります。定例の資料を作るのも、推薦の傾向を振り返るのも、次にどう伝えるかを考えるのも、担当者の経験と手作業に依存している。だから担当者が忙しくなれば止まりますし、担当が変われば引き継がれません。 ここを、AIが実務を回しながら蓄積した選考データで高度化できないか。そう考えて作ったのが、今回ご紹介する機能です。
人材紹介をしていた頃、手元にあった情報の限界
そもそも、なぜ私たちがこの機能に行き着いたのか。それは、前身の事業で人材紹介をしていたときの経験があるからです。 企業から求人票をいただき、候補者を探して推薦する。その中で常に課題として感じていたのが、選考が進む中で変化していく採用基準を、リアルタイムに把握しきれないということでした。
推薦にあたっては、当然ながら求人票だけを見ているわけではありません。担当者との打ち合わせで伺った背景に加えて、コーポレートサイトや技術ブログ、社員インタビューの記事まで読み込みます。技術ブログを見れば、モダンな構成を組んでいるのか、レガシー環境の改善フェーズなのかが分かりますし、社員インタビューを読めば、どういうバックグラウンドの方が入社して活躍しているのかが見えてきます。 そうして集めた情報から「この会社なら、こういう技術スタックの経験があって、こういうバックグラウンドの方が合う」という仮説を立て、精度を上げながら推薦していました。
ただ、この仮説に完全な再現性を持たせることは、構造的に難しいというのが実感でした。 見送りのご連絡は「今回はご経験が少し要件と異なるため」といった数行で返ってくることが多く、経験年数なのか、技術スタックの方向性なのか、書類上の見せ方なのか、どこを調整すべきかまでは読み取れません。通過した方についてヒアリングをしても、「経験がマッチしていました」といった回答から、それが決め手のすべてなのかを判断することはできません。
たとえば、ある候補者の方が書類で見送りになったとき、返ってきたのは「今回はご経験が要件と異なるため」という数行でした。ただ、その方のご経験を考えると要件から大きく外れているとは思えなかったので、職務経歴書の見せ方に原因があるのではないかと考えました。そこで実績の書き方を整理し直し、担当されていた領域や成果がより伝わる形に組み替えた上で、別の企業に推薦しました。結果として、その方は書類選考を通過されました。
ただ、最初の企業で見送りになった理由が本当に見せ方だったのかは、最後まで分かりません。書き方を変えたことが効いたのかもしれませんし、そもそも企業ごとに評価する観点が違っただけかもしれない。正解のデータがないので、仮説が検証されないまま次に進むことになります。当たった推薦も、外れた推薦も、なぜそうなったのかが手元に残らないため、毎回苦戦するといったことがありました。
そして採用基準は、選考が進むにつれて動いていきます。何人か面接をした結果として現場の見方が変わることもあり、その変化が共有されないまま推薦を続けると、精度を上げてきたはずの仮説が、いつのまにか現状とずれていくことになります。
求人票だけでは「本当に通る人」が分からない
なぜこのようなズレが起きるのか。 理由はシンプルで、求人票ではなく、企業の(あるいは現場の面接官の)頭の中にこそ本当の採用基準があるからです。
求人票は、募集を開始するときに作成する静的なペルソナにすぎません。しかし実際の採用活動は動的です。現場の状況、チームの充足度、何人かの候補者と会った上での「やっぱりこういう経験がある人が欲しい」というリアルタイムな感覚の変化によって、合否の基準は日々更新されていきます。 人材紹介側にとって難しいのは、その変化が起きたことすら分からない点です。求人票は変わっていないので、こちらは同じ基準で探し続けます。実際には現場の見方が動いていて、以前なら通っていたはずの経歴が通らなくなっている。そのことに気づくのは、見送りが続いて「何かおかしい」と感じてからです。
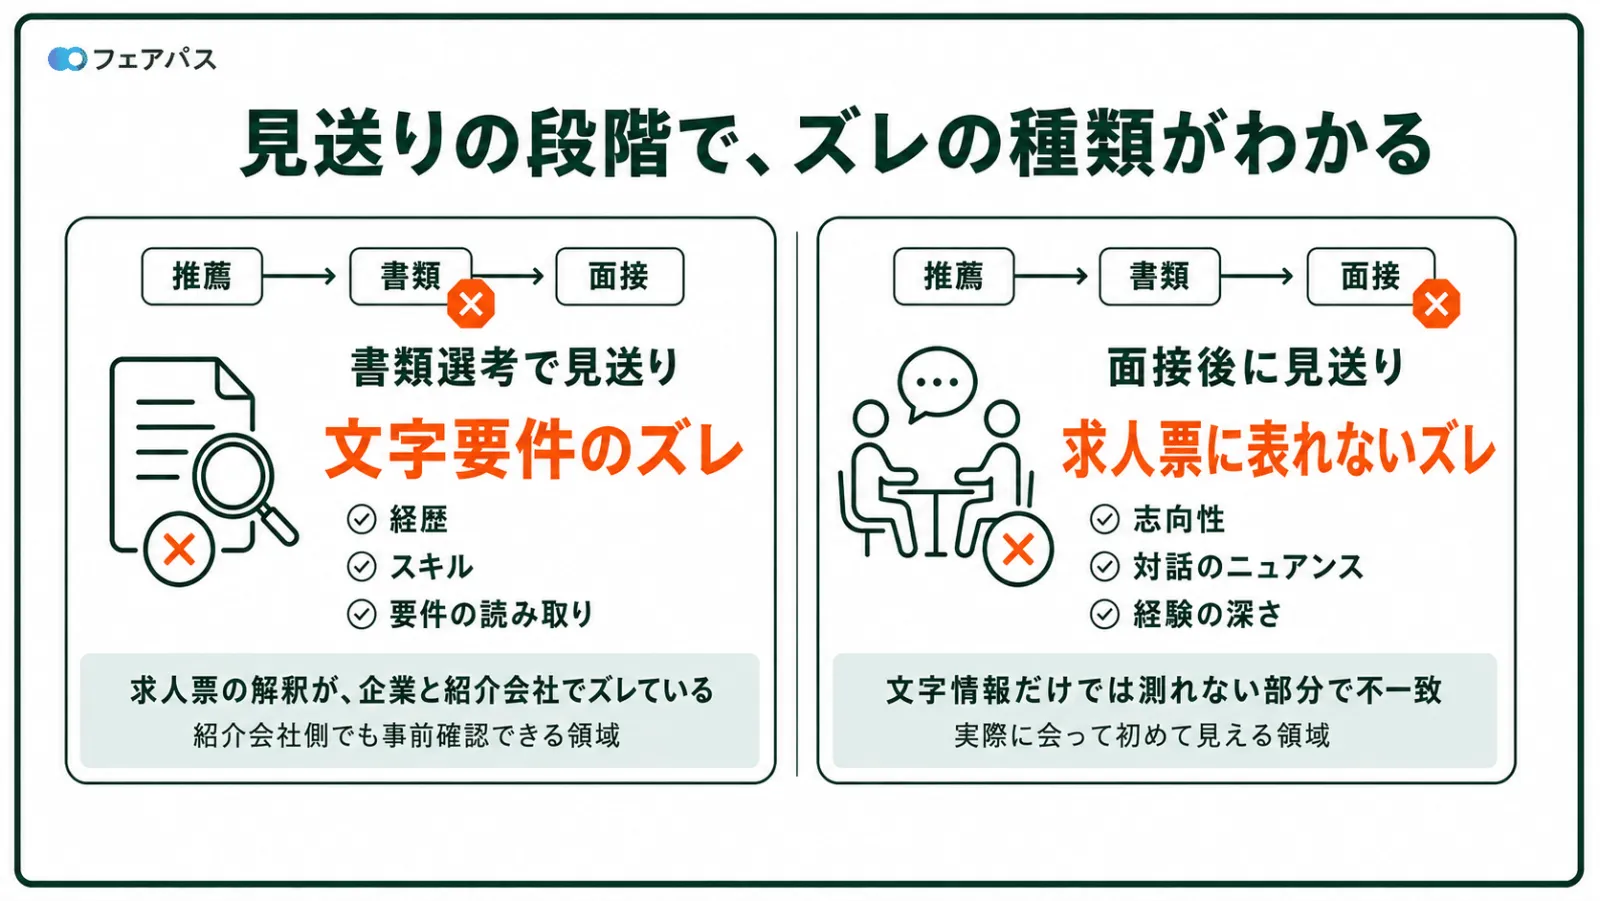
だからこそ、エージェントが本当に欲しいのは求人票の再共有ではありません。**「直近で誰が通ったか」「どこで落ちたか」「何が評価されたか」「惜しくも落ちた方には何が足りなかったか」という、生きた選考データです。 ** なお、同じ見送りでも書類段階と面接段階では意味が異なります。書類であればスクリーニングの基準や書類上の見せ方、面接であれば志向性や経験の深さといった、書類では判断できない部分でのミスマッチです。エージェント側が次に調整する箇所も変わってくるため、選考フェーズごとに切り分けて共有できることが前提になります。
内定者だけを分析する必要はない
もう一つ、従来の採用分析やエージェントフィードバックには大きな落とし穴があります。それは、内定者のデータだけを分析しようとすることです。
もちろん、内定を承諾した方の共通点を分析することは重要です。しかし、中途採用における内定は非常に母数が少なく、企業によっては数ヶ月に1名しか出ないことも珍しくありません。「内定者データが溜まったら分析しよう」と考えていると、データが足りなすぎて、いつまで経ってもエージェントへの具体的なフィードバックが作成できないのです。
本当に見るべきなのは、内定者だけではありません。
- 最終面接まで到達した人 (内定は出なかったが、限りなく理想に近かった人)
- 一次面接を通過した人 (書類選考を突破し、現場が「会ってよかった」と感じた人)
- 書類を通過した人 (第一印象としての経歴要件を満たしていた人)
- 書類で見送りになった人 (事前のスクリーニング条件に合わなかった人) このように、各選考ステップの通過者と見送り者の傾向をグラデーションで捉えることで、母数が少ない状態からでも、十分に高い精度で「いま通る人・落ちる人」の傾向をデータとして抽出できます。
実務を回すAIが、データを分析してエージェントに返す
これら選考フェーズ別の生データや、不合格者のグラデーションデータは、実は企業のATS(採用管理システム)の中に、歴史としてすべて眠っています。
しかし、人事がこれらを1件ずつ手作業で集計し、「直近3ヶ月の書類通過者はこういう経歴で」「一次面接で見送りになっている理由はここに偏っていて」と分析して紹介会社向けにまとめるのは、時間と手間の観点から現実的ではありません。日々の調整業務だけで、人事の一日は終わってしまうからです。
だからこそ、この役割を採用AIエージェントOS(フェアパス)が担います。 フェアパスは、日程調整やエージェント連絡といった日々のオペレーションを実行しています。実務を直接回しているので、その結果として選考データが自動的に一箇所に溜まっていきます。そのデータをAIが分析し、エージェントとのコミュニケーションに返していく。
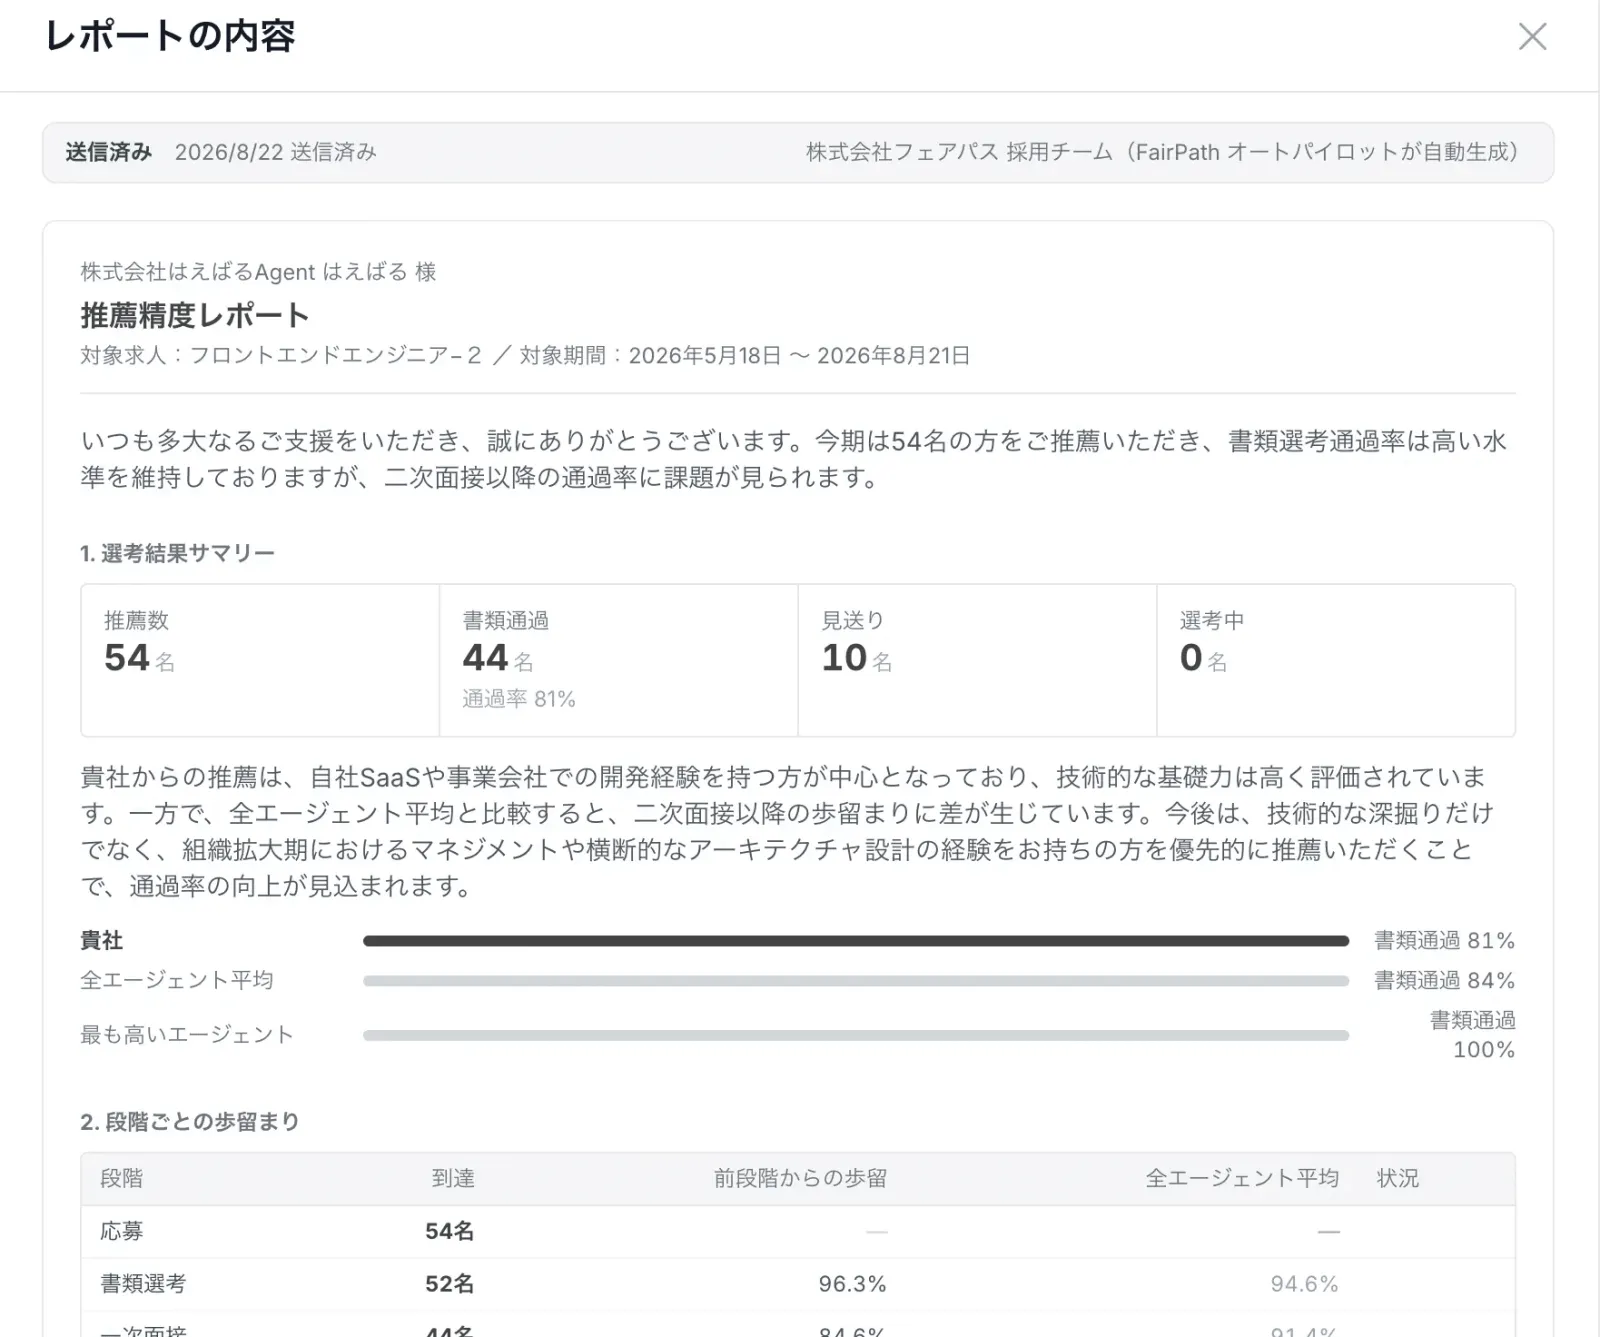
AIが実務を回す。データが蓄積される。AIが分析する。エージェントに返す。推薦の精度が上がる。その選考結果がまたデータとして溜まる。 この循環をつくることが、今回の機能で実現したいことです。そして、この循環の中で実際に返しているアウトプットの一つが、次にご紹介する推薦精度レポートです。
レポートサンプル①
情報が渡ると、推薦の質も量も変わる
これだけの情報量を含んだデータをエージェントに返す。これこそが、私たちが人材紹介をしていた頃に「これをもらえたら、仮説の精度を上げ続けられるのに」と思っていた情報の姿そのものです。
「もっと良い人を推薦してください」という感覚的な要望ではなく、「直近、書類を通過している方と、二次面接で惜しくも見送りになっている方の境界線はここです」という一次データを共有する。 これを受け取った人材紹介会社は、推測で補っていた部分を実際のデータで置き換えられるようになります。先ほどの職務経歴書の例でいえば、見せ方の問題だったのか、そもそも評価される観点が違ったのかが分かる。仮説を修正する材料が毎回返ってくるので、推薦を重ねるほど精度が上がっていきます。
そして変わるのは質だけではありません。エージェント側からすると、通る人が分かっている求人は動きやすいものです。探す範囲を絞れますし、候補者に対しても「この会社ではこういう方が評価されています」と具体的に伝えられます。推薦にかかる時間そのものが短くなるので、**結果として推薦の量も増えていきます。 ** 情報が足りないまま慎重に出すのではなく、情報があるから的確に、そして多く出せる。この状態を目指しています。 結果として、企業側も古い求人票のせいで届くズレた候補者への書類選考が減っていきます。お互いにとって、時間の使い方が変わることになります。
フェアパスが実装している機能 この循環を回すため、フェアパスには以下の機能が実装されています。
推薦傾向と選考結果フィードバックの自動集計 日程調整やエージェント連絡などの日々の実務をフェアパスが直接行っているため、データが自動的に一箇所に溜まります。AIがその履歴から、紹介会社ごとの推薦の傾向、選考フェーズ別の歩留まり、定性的な見送り理由の共通点を自動で集約します。 実際に生成しているレポートには、以下の項目が含まれています。
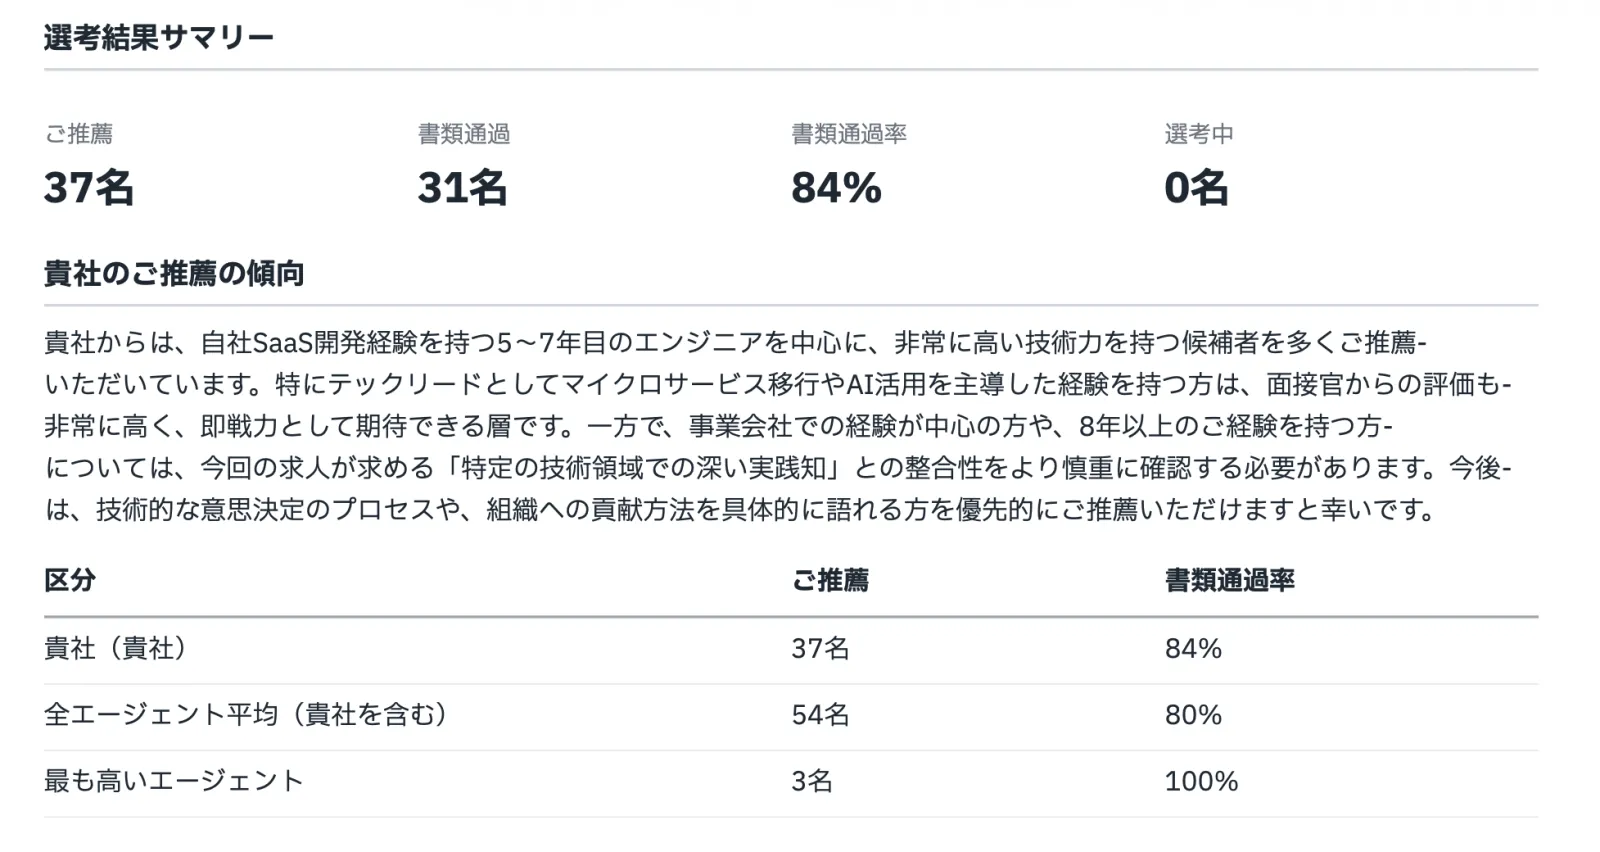
- 選考結果サマリー:推薦数、書類通過数、通過率、選考中の人数
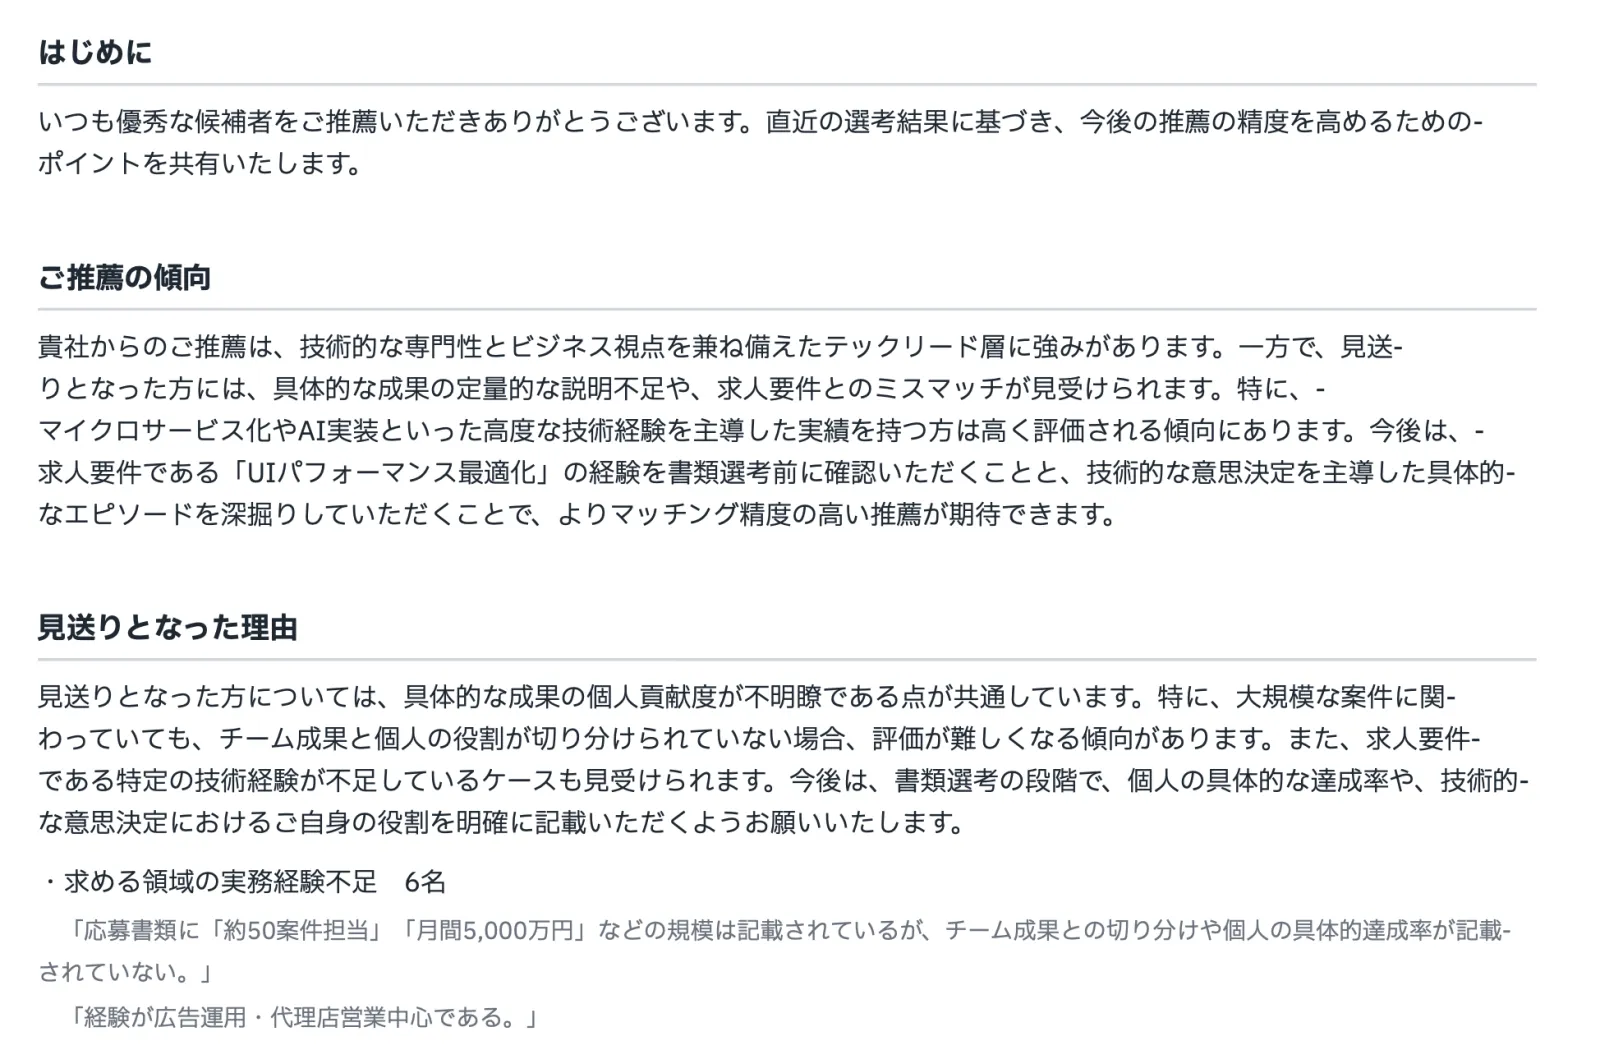
- 推薦の傾向:どういう層に強みがあり、どこを慎重に確認すべきか
- 見送り理由の内訳:理由ごとの件数と、書類のどの記載が不足していたかの具体
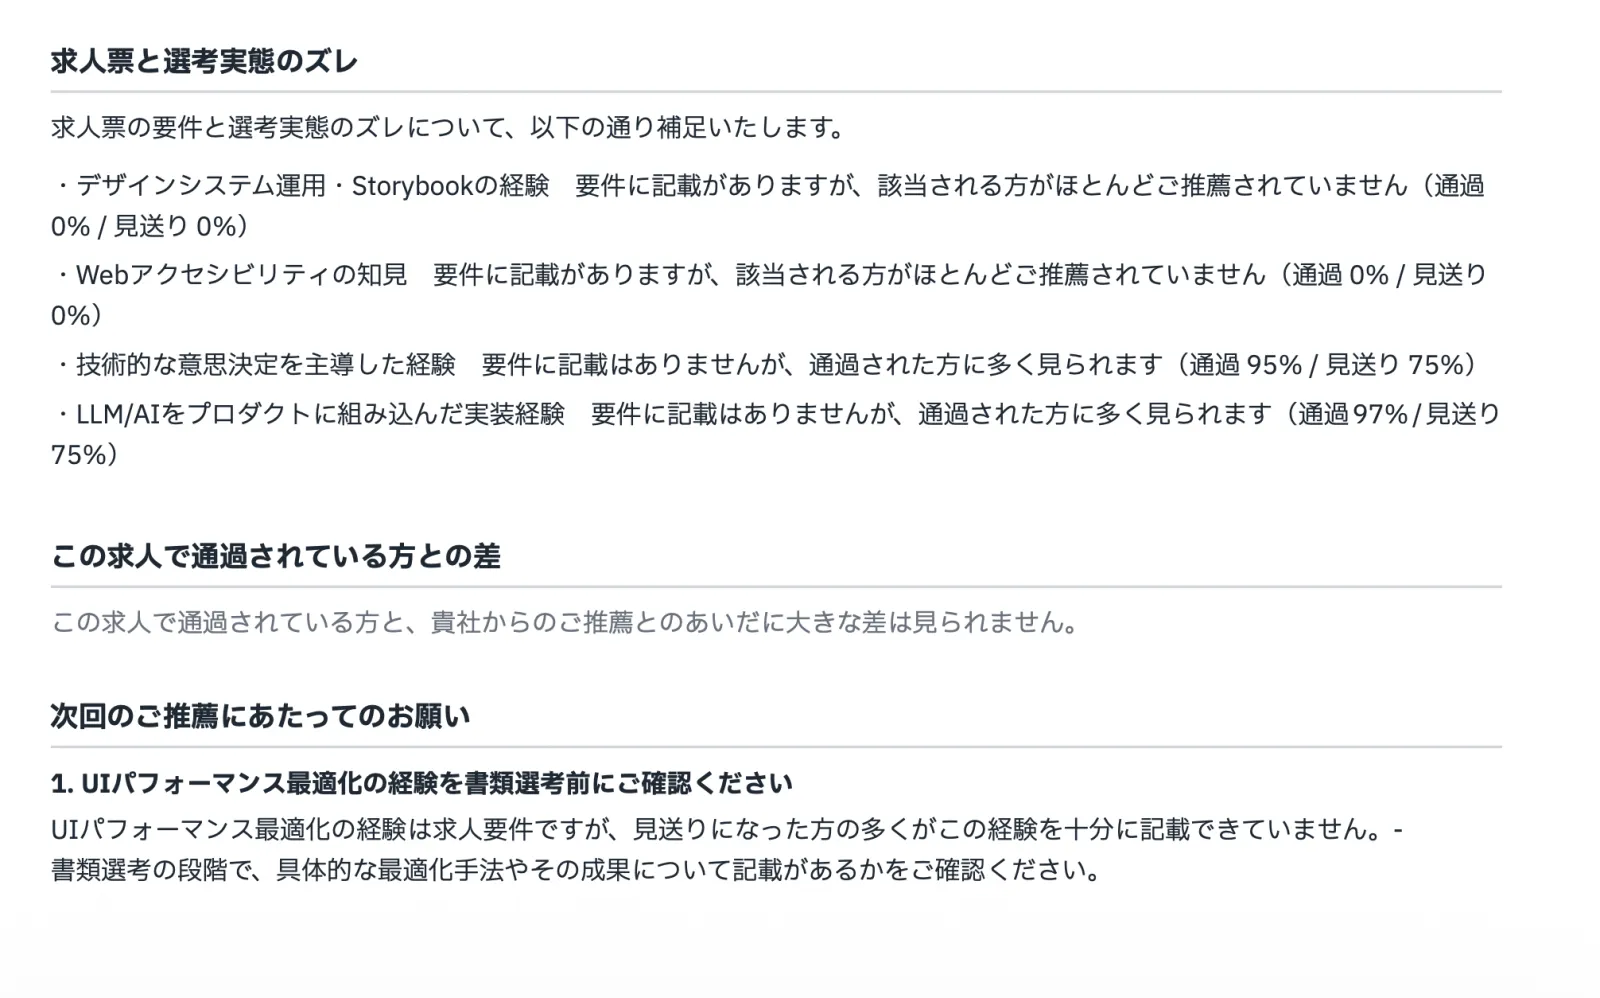
- 求人票と選考実態のズレ:要件に書いてあるのに推薦されていない項目と、要件に書いていないのに通過者に多い項目
- 他エージェントとの比較:自社/全社平均/最も通過率の高い社の並記
- 選考の歩留まり:フェーズごとの到達数と通過率、他社平均との差
- 月次の推移:推薦数と通過率の変化
- 通過者に共通していた要素:定性的な傾向と、該当した人数
- 次回の推薦にあたってのお願い:確認してほしい観点を具体的に
レポートサンプル②-1
レポートサンプル②-2
レポートサンプル③-3
**データに基づく紹介会社向けレポートの自動作成 ** 「もっとこういう人を推薦してほしい」という感覚的な要望ではなく、上記のサンプルにあるような定量+定性の実績データを網羅した紹介会社専用のレポートを、AIが裏で自動作成します。
採用モデルイメージ
人の確認と承認を挟む送信フロー いくらAIが自律してレポートを作成するといっても、紹介会社との関係性や、社外に出すべきではない情報がそのまま送信されてしまうのはリスクがあります。そのためフェアパスでは、送信ボタンを押す前に人が中身を必ず確認・修正し、承認を出すステップを設計しています。ブラックボックスにするのではなく、人間の最終意思決定を残した、コントロール可能な自律システムにこだわっています。
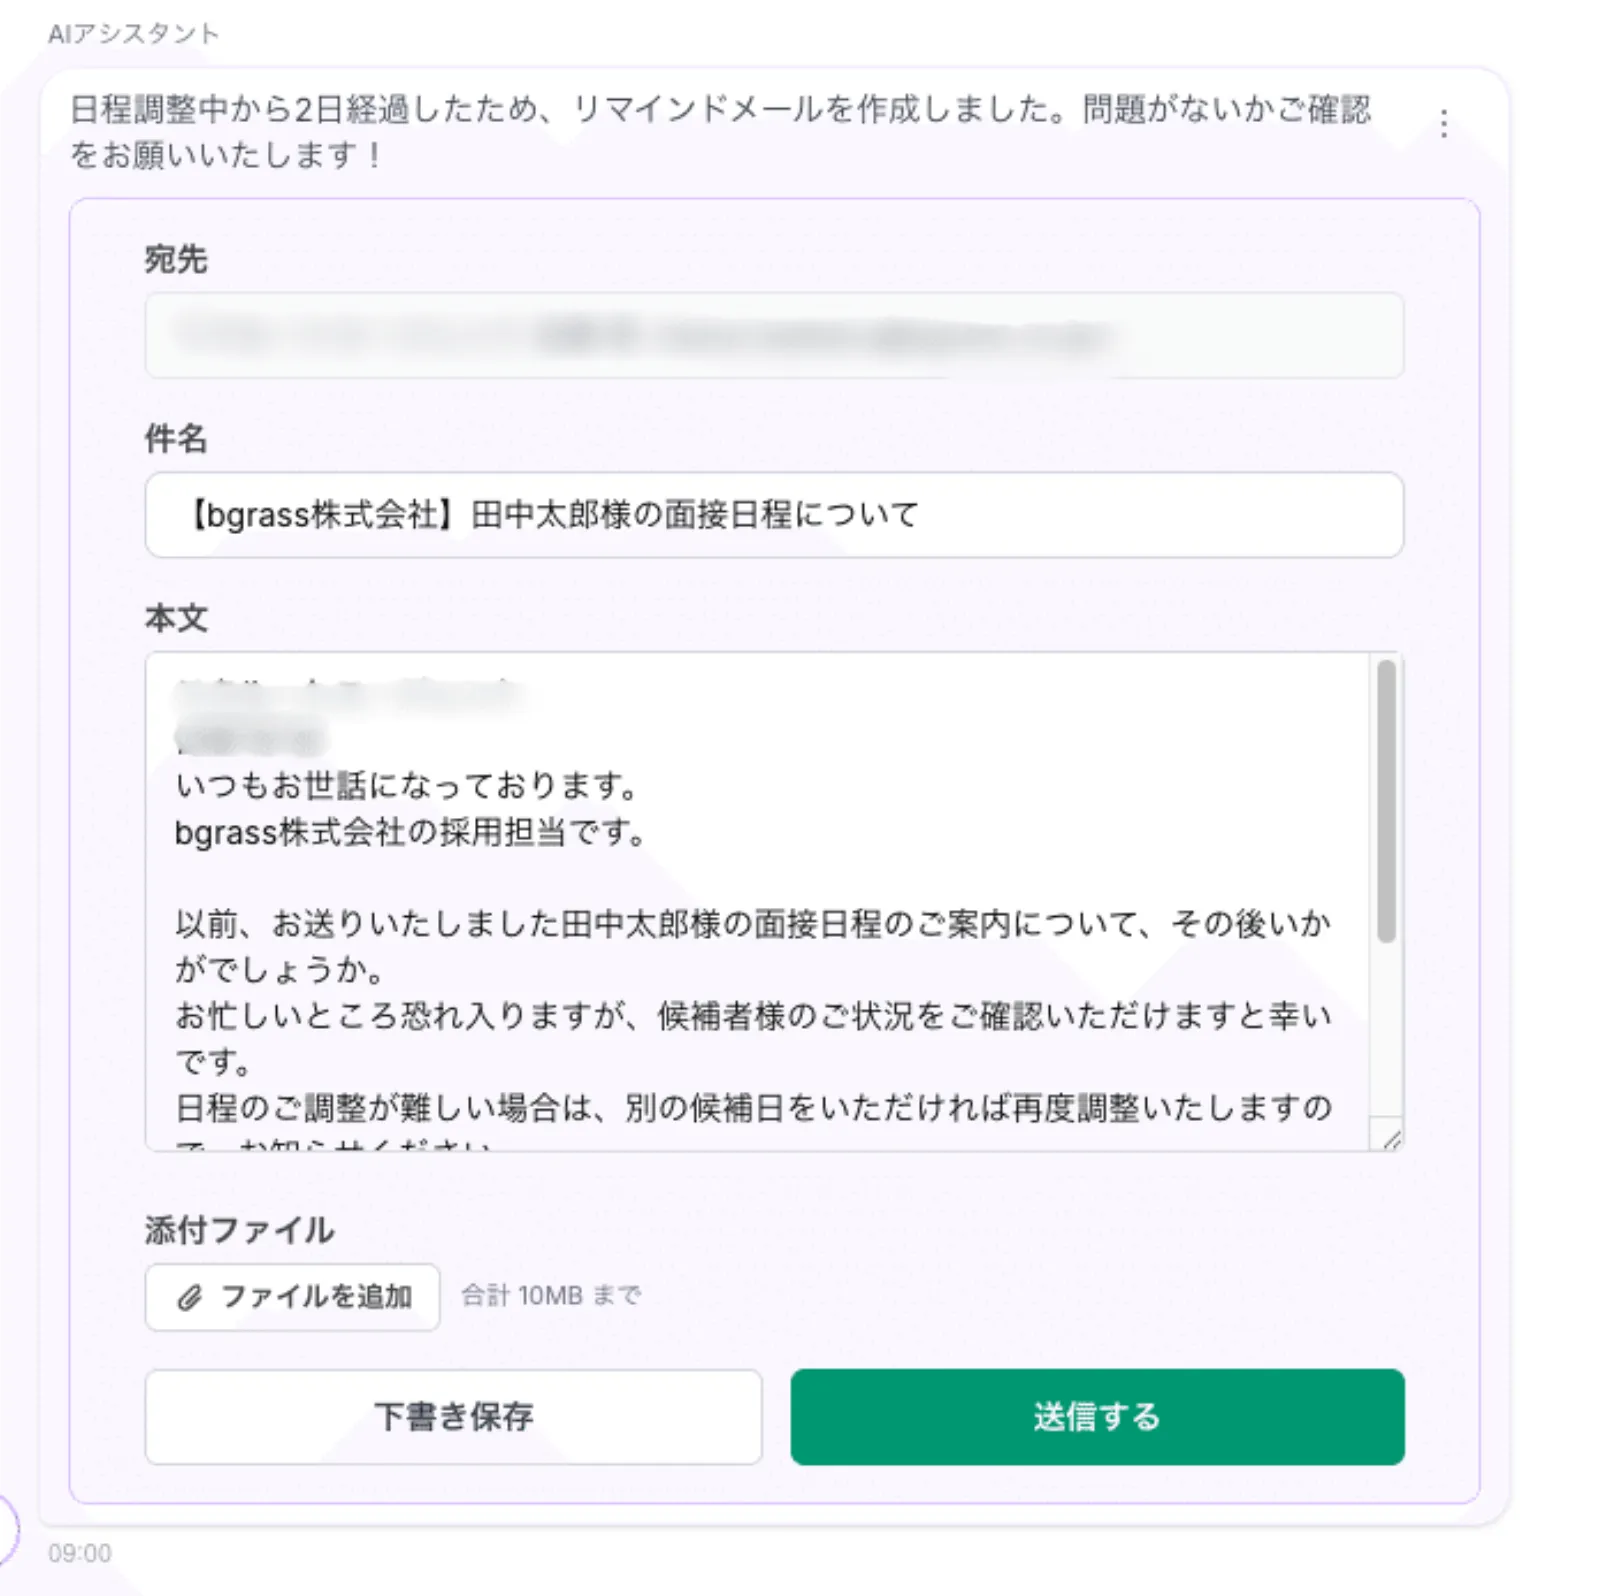
送信ボタンを押すのは人間
まずは1求人から、実務をAIに任せてみる
紹介会社との定例会の準備に、毎週何時間もかけてスプレッドシートを集計する。届く推薦がズレていることに困りながら、求人票を何度も書き直す。そんな管理のための手作業は、すべてAIに任せてしまいましょう。 いきなりすべての求人や、すべての紹介会社とのやり取りをフェアパスに移行する必要はありません。
まずは、採用に最も苦戦している、あるいは紹介会社からの推薦が一番ズレている1つの求人だけでスモールに試してみてください。その1求人だけでも実務とデータが繋がる状態を作ることで、紹介会社から届く推薦の質が変わっていく感覚を、低いコストで実感していただけるはずです。
現在、レポートの粒度や送付のタイミングは今も調整を重ねている段階ですが、どの情報をどこまで共有するのが最適かは、企業と紹介会社の関係性によっても変わります。それでも、感覚のやり取りをデータに置き換えるだけで、推薦のズレは確実に縮まります。
人材紹介会社と強調して採用を成功に導くエージェントコミュニケーションについて、以下のホワイトペーパーにまとめています。まずは小さく、AIに実務を任せてみる第一歩として、ぜひダウンロードしてご覧ください。
▼採用基準を同期し続ける 人材紹介エージェントコントロール
執筆者|まいか bgrass株式会社|BizDev 採用AIエージェント「フェアパス」の導入現場で、採用オペレーションの設計・改善支援に従事。フリーランスとしても複数企業の採用支援・採用戦略立案を担当し、採用実務とAI活用の両面から現場に伴走している。